01 / SAME IMAGE, DIFFERENT METHODS
看同一处裂缝,比较实际差异。
这张图怎么看
本张图片的实验与对齐记录
本地裂缝模型均以 512 像素分块、25% 重叠、CPU FP32 重跑,使用各自固定阈值;“自动道路”额外使用网站道路筛选。v2.22 为未发布研究候选。GPT 每图单次生成,仅输入原图,未输入标签或其他预测;工具未公开后端型号。
固定规则提取红色:R ≥ 160,R−G ≥ 70,R−B ≥ 70;最近邻映射回原图尺寸,不膨胀、不补洞、不依据标签调阈值、不做几何纠偏。背景特征位移只用于检查整体对齐,不能证明每处裂缝边界都准确。
02 / MASKS & MEASUREMENTS
掩码能生成,精度要实测。
GPT 生成的区域可以转成 0 / 255 二值掩码,再和你的模型使用相同的评价与量测程序。下面保留逐图结果,避免平均分遮住某一类问题。
| 方法 | IoU | Dice | 面积 px² | 面积偏差 | 主路径长 px | 主路径最大宽 px |
|---|
面积为全掩码白色像素数;长度与最大宽度沿用网站对选定主连通分支的量测算法。断裂或连接会改变选中的分支,因此长度差异不等同于对同一条裂缝的物理误差。没有尺度标定,结果只用像素表示。
分组汇总
| 方法 | 平均 IoU | 平均 Dice | 平均 Precision | 平均 Recall |
|---|
提示词会影响掩码
之前要求“细红线”,提取的是描线像素;新样本要求填满可见裂缝区域。二者分别展示,没有当作严格的同图提示词消融。
面积接近,形状仍可能有差异
DeepCrack 样本中,GPT 面积偏差约 −0.71%,主路径长度相对标签却约 +80.51%。连通关系与标签中的断点需要单独复核。
筛选步骤也会造成漏检
DeepCrack 样本中,v1.7 全图 IoU 为 71.62%,加自动道路后为 60.77%。应一起检查道路范围、裂缝预测和最终输出。
查看“红线 → 二值掩码 → 叠回原图”的实际示例
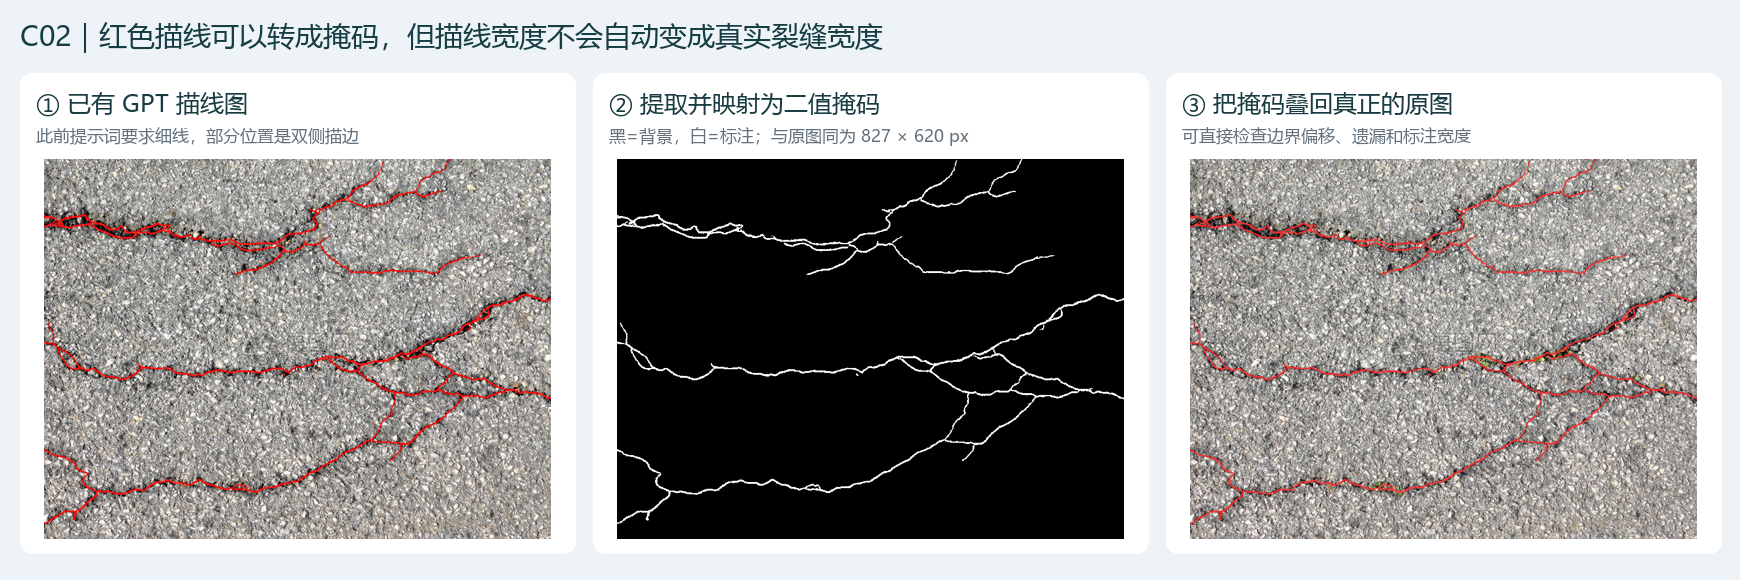
转换保留了所画区域。若画的是中心线或双侧边线,转换不会自动还原裂缝内部,也不会自动校正真实宽度。
03 / CAPABILITY LANDSCAPE
同类方法,按输出能力比较。
识别语义、定位区域、生成掩码和测量几何是不同能力。这里列出可验证的输出形式及本项目的实测状态,其他方法的裂缝成绩需要在相同样本上补测。
| 方法路线 | 能提供什么 | 本次证据 | 下一步怎么比较 |
|---|---|---|---|
| 本项目专用裂缝模型v1.1 / v1.7 / 候选 v2.22 | 原图坐标下的概率图、二值掩码;支持本地批量处理。 | 已同图重跑 共 9 张;5 张有标签。 | 用独立道路、拍摄尺度和光照分组复测,并记录耗时、漏检与边界误差。 |
| GPT 图像生成工具本会话内置工具;后端型号未公开 | 生成区域标注图,经颜色提取和尺寸映射获得掩码。 | 已转换并评价 3 张区域生成;6 张已有细线生成。 | 固定版本、提示词与提取规则,增加重复生成与独立样本;检查几何漂移。 |
| SAM 3可提示分割基础模型 | 文字、点、框等提示驱动,直接返回 masks、boxes、scores。官方实现 ↗ | 未进行本项目实测 | 分别测文字提示和人工点框提示;记录交互成本,不能把人工辅助当作全自动。 |
| Gemini 分割接口多模态模型的结构化输出 | 当前官方示例返回框、标签和归一化多边形,可栅格化为掩码。官方文档 ↗ | 未进行本项目实测 | 固定具体版本、坐标映射与栅格化规则,检查细裂缝和孔洞表达。 |
| Qwen3-VL 等视觉语言模型理解、定位与工具协作 | 支持视觉定位,可作为分割流程中的定位与解释模块。官方实现 ↗ | 未进行本项目实测 | 明确最终由哪个分割器输出像素区域,把定位和分割各自的误差拆开。 |
能力格局会变,项目结论要绑定版本和任务
官方仓库在 2026 年 3 月发布了 SAM 3.1 的多目标跟踪更新。这说明能力会持续迭代,但更新更快或通用评测更高,不能直接推出本项目的细裂缝宽度更准确。建议在候选版本变化时重跑固定基准,而不是按发布热度给模型排序。
04 / NEXT RESEARCH DIRECTIONS
下一步,让边界、尺度和证据一起进步。
先把“要识别什么”统一
统一裂缝、接缝、阴影和植被遮挡的标签口径;保留原始比例,覆盖不同拍摄高度与路面。
验证方式:固定模型与训练设置,只替换数据清理或补样方案。
把像素分数与量测误差一起看
补充边界误差、分支完整性和断点检查,避免用一条更连续或更细的线代替正确区域。
验证方式:固定掩码量测算法,人工复核同一分支,再做尺度标定。
用大模型辅助标注与难例复核
尝试生成标注初稿、提示式分割和人工修订;保留修订耗时,决定哪些环节值得接入。
验证方式:分别比较全自动、人工提示、领域适配三种条件。
以新道路上的稳定表现决定升级
按道路、飞行批次或原图分组划分,避免同图裁块泄漏;同时记录延时、资源与成本。
验证方式:开发集选方案,独立测试集作最终验收;固定版本留档。
“换成更高清的数据集,模型就很强了?”
数据影响很大,但本项目同时经历了标签清理、近景与航拍适配、恢复原始比例、道路筛选和训练策略调整。4060 张清理后训练样本加 880 张航拍形成旧联合池;再加入 1806 张新道路样本形成 6746 张联合训练池。候选 v2.22 使用同一联合池继续改变裁图与训练策略,因此不能把每次提升都归因于新增高清图片。
数据作用的因果结论仍需要控制其他变量的消融实验;当前页面提供的是固定样本上的模型与推理流程对照。
资料来源与进一步阅读
- Meta:SAM 3 与 SAM 3.1 官方仓库
- Google:图像理解与分割输出
- OpenAI:图像理解、精确定位与缩放限制
- Qwen:Qwen3-VL 官方能力说明
- CrackSAM:基础模型的裂缝领域适配研究——支持尝试领域适配,不代表本项目已经复现论文成绩。